过去两年,大多数制造企业的AI实践停留在“给建议”的阶段,大模型回答工艺问题、生成报告初稿、辅助文档检索。但进入2026年,一条更深的暗线浮出水面:AI开始“做任务”了。
工信部披露的数据显示,超过30%的规模以上制造业企业已实现AI技术覆盖,近200项AI关键标准研制成功。更值得关注的是,今年4月工信部与国家数据局联合启动的“模数共振”行动,明确将汽车列为20个重点行业之一,提出攻关“蕴含工业和信息化领域技术机理的行业模型、专用模型和特色智能体”。
换句话说,政策层面对工业AI的期待,已经从“能用”升级为“懂行”。这恰恰是当前工业AI落地最难的一关。通用大模型不懂热管理系统的部件共存规则,不会判断某个零部件是否适配特定车型,更无法在MBSE的复杂链路中保证数据从原始需求到组件需求的可追溯性。
一家头部汽车制造企业正在验证的一条技术路线,提供了一种值得拆解的解题思路。
从“人在工具间游走”到“AI智能调度工具”
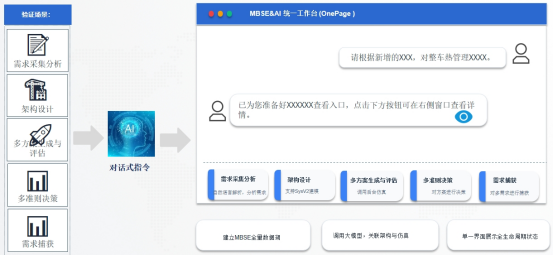
这家企业在完成两期MBSE功能建设后,面临一个典型困境:MBSE平台功能模块繁杂、设计师学习成本高、全流程效率被工具切换严重消耗。
他们的选择不是继续堆功能,而是把整个MBSE工作台压缩到一个单页面里,对标豆包等消费级AI产品的交互体验,用自然语言驱动全流程。不是交互层面的“减法”,而是AI能力边界的精准划定。
用专业知识库让AI工作更可信
在智能架构设计环节,团队没有让AI直接全量生成SysML v2代码,而是先让AI根据输入的研发需求,智能匹配最相似的历史车型,然后基于复用的历史车型模型做进行智能增量迭代调整。原因很实际,全量生成不可控、难验证,而且历史车型已验证的SysML模型本身就是最可靠的起点。
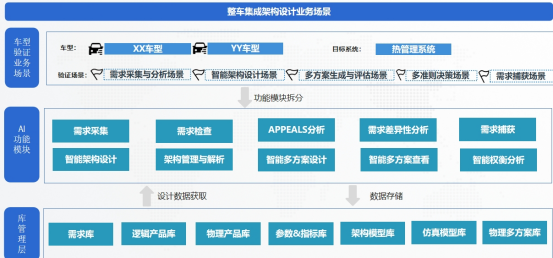
这个选择背后的判断是:用历史知识库让工业AI的生成更加可信。
“本体”才是工业智能体不幻觉的底牌
多方案生成环节最能体现这种思路。基于逻辑架构调用真实产品库数据后,系统会通过业务本体规则过滤无效组合,部件是否共存、是否适配目标车型、接口是否匹配,全部由规则引擎判定。
无约束时可能生成上万套方案,加上业务约束后压缩至8套左右,再用自研轻量化仿真脚本完成性能验证。这里的关键词是“本体”。在“模数共振”行动的政策语境中,这对应的是“蕴含行业技术机理”的模型能力。
这家企业把业务对象定义、部件共存规则、车型适配规则等本体能力嵌入到方案生成和仿真环节,本质上是给AI装上了一套工业领域的“物理常识”。大模型可以不懂热力学,但系统知道冷凝器和压缩机之间必须满足什么接口约束。
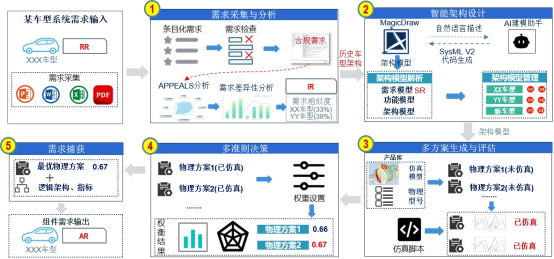
所有零部件和仿真模型数据从客户真实产品库调用,禁止AI自由生成不存在的零部件。全局数据湖承接所有AI中间产物,只有用户确认后的有效数据才能正式入库,未入库和仿真报错的数据标记对应状态。
这套“中间态与正式态分离”的机制,让AI的试错成本被控制在数据湖层面,不会污染正式模型库。
这家汽车企业的探索提供了一个样本,AI做交互和调度,规则和工具保证准确,历史模型保证可复用,真实产品库保证可落地。这条路走通了,工业AI才真正从演示走向生产线。
扫码即可预约一对一线上演示,看单页对话式研发工作台如何接入你现有的产品库与模型库